深度解析 GPT-6 Astra:重塑金融研究效率与 AI 安全防御新标准
随着 AI 前沿模型的飞速发展,如何平衡强大的推理能力与严格的安全边界已成为行业核心课题。近期,OpenAI 展示了其最新模型 GPT-6 Astra 在金融实战场景中的表现,并详细披露了针对**对抗性蒸馏(Adversarial Distillation)**的安全加固技术。本文将结合 Hebbia 的应用案例,探讨 GPT-6 Astra 如何改变专业工作流,以及 OpenAI 如何在底层架构上捍卫其模型资产。
一、 金融研究的质变:GPT-6 Astra 在 Hebbia 的实战表现
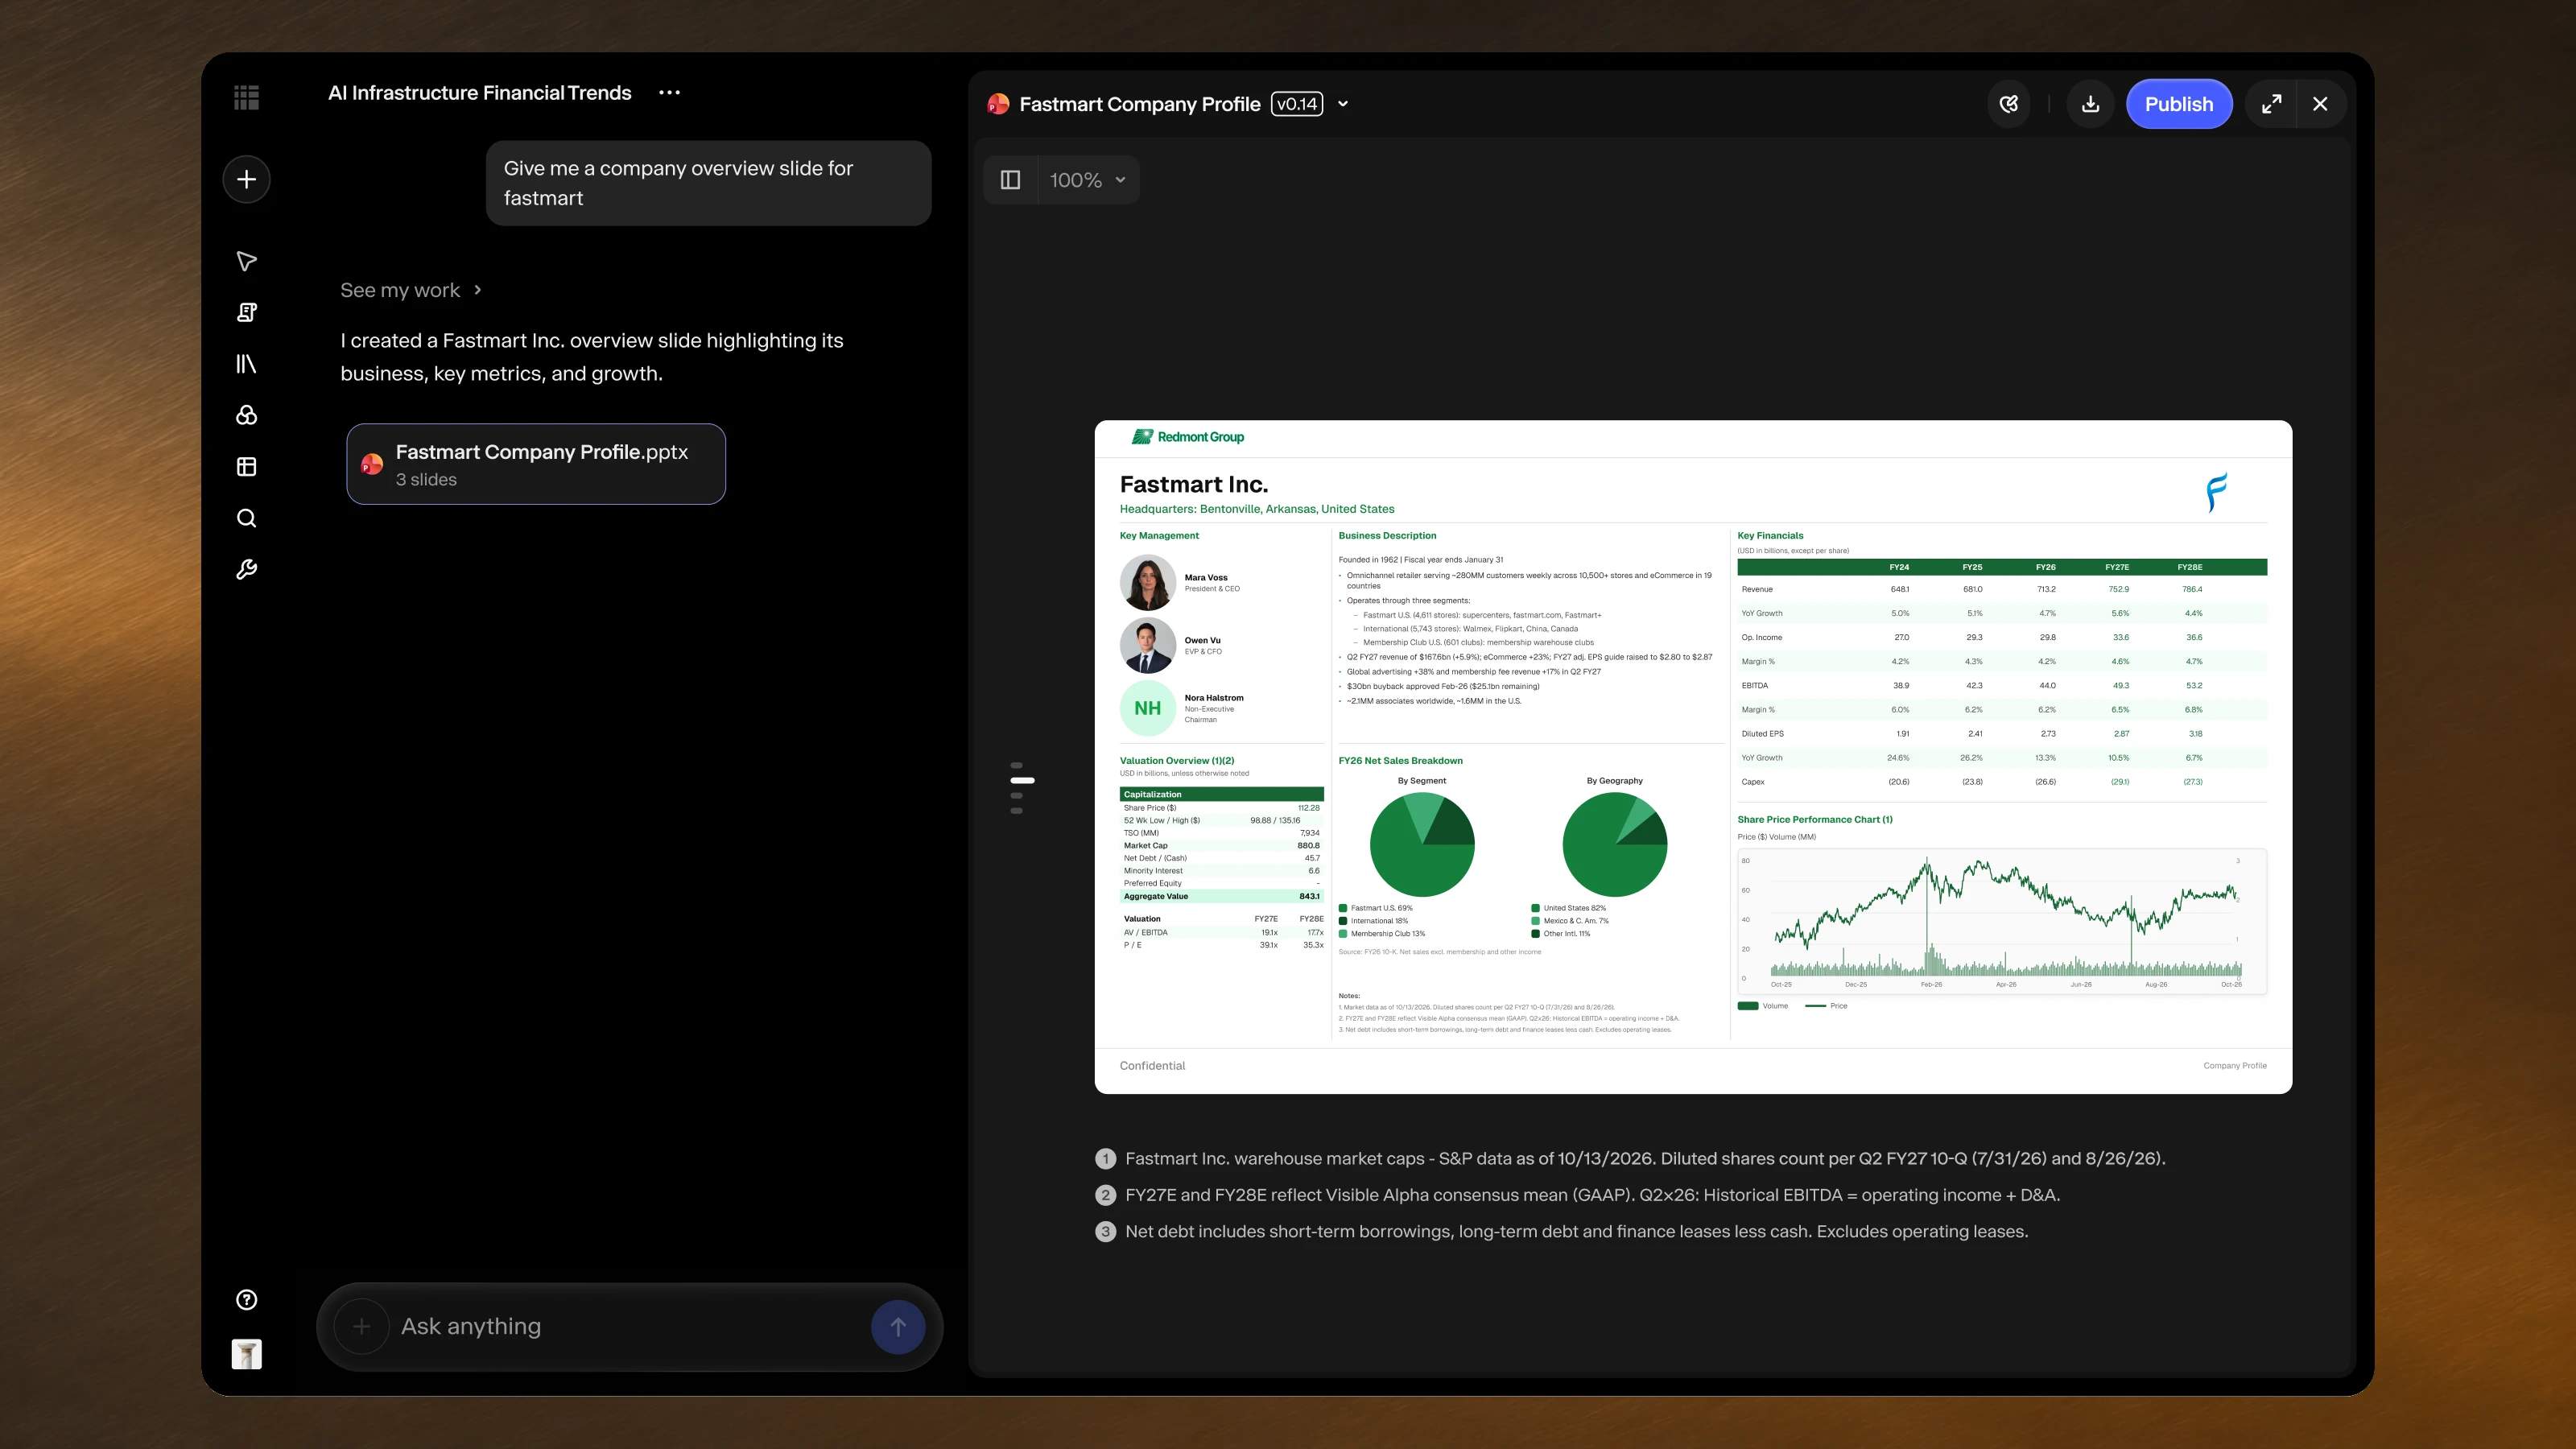
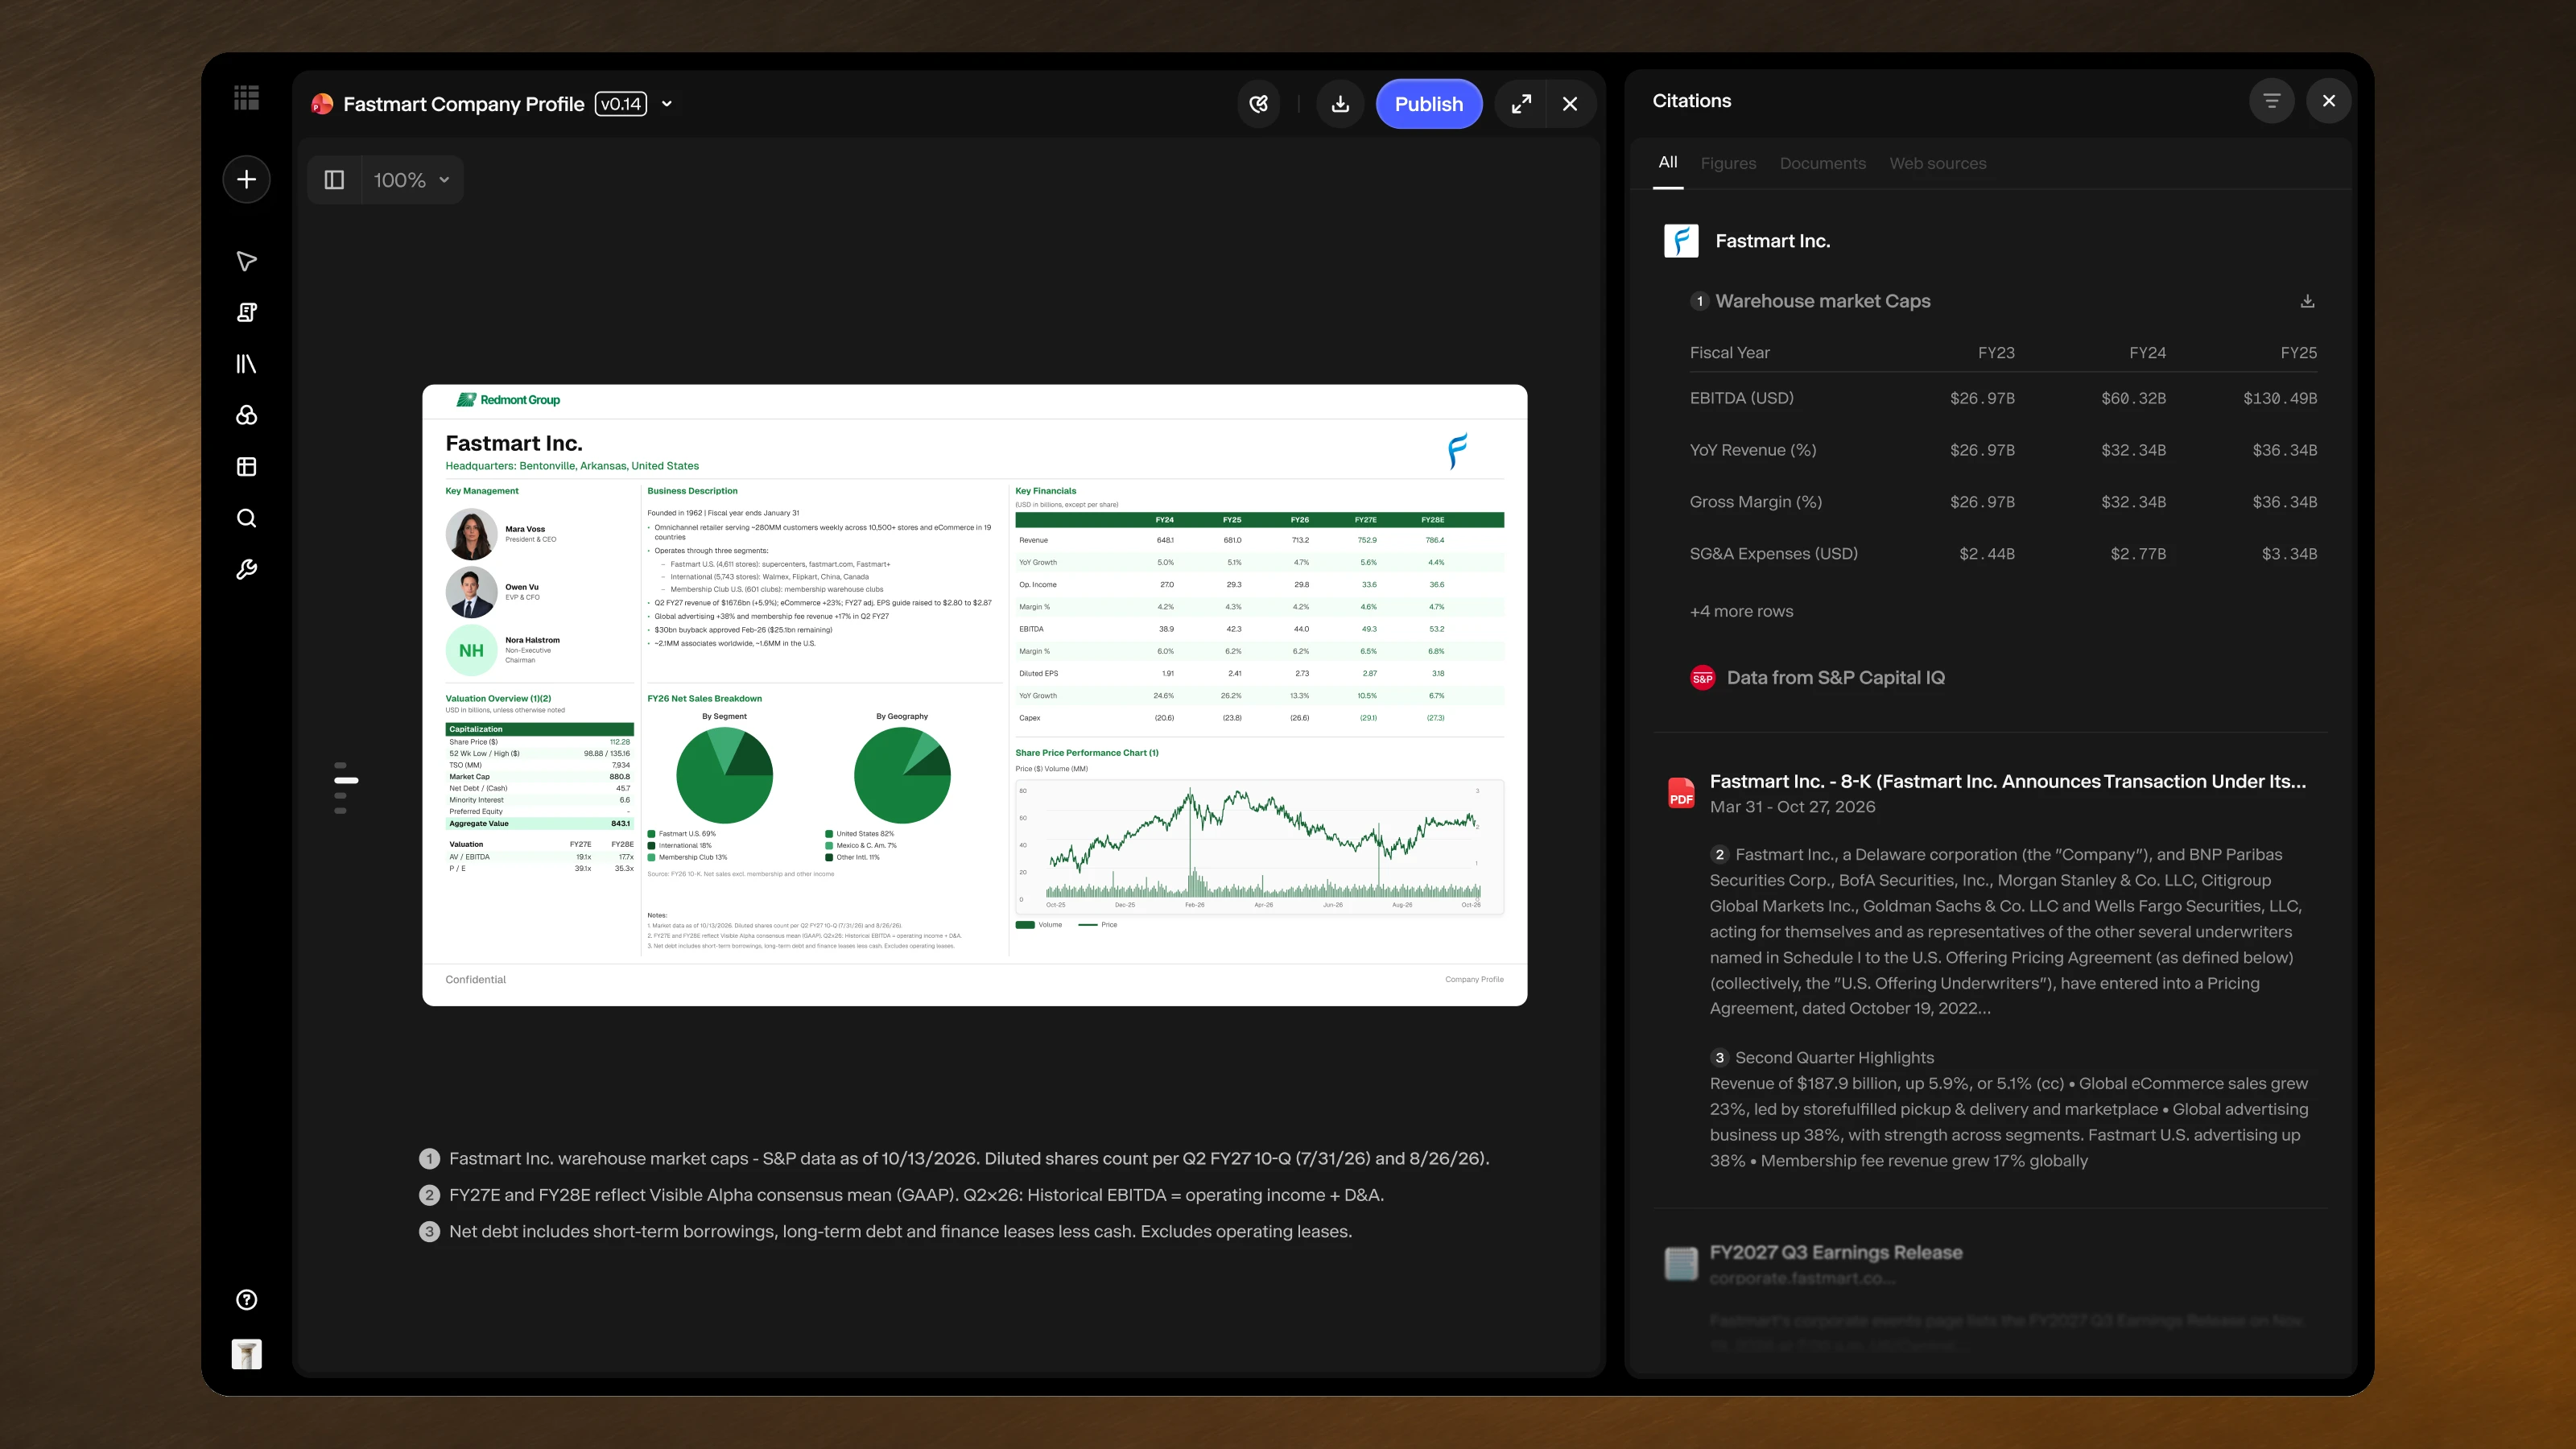
对于金融分析师和投行家而言,处理数千份财务报表、合同和演示文稿是日常工作的重心。初创公司 Hebbia 旗下的 Matrix 平台近期对其进行了预发布评估。结果显示,GPT-6 Astra 在寻找来源证据和自动化报告生成方面达到了前所未有的精度。
核心测试数据对比:
| 维度 | GPT-6 Astra 表现 | 领先同类最佳模型幅度 | | :--- | :--- | :--- | | 引用来源覆盖率 | 高出 13.6% | 13.6 个百分点 | | 引用相关性精度 | 99.5% | 极高准确度 | | 演示文档要求达成率 | 97.9% | 14.4 个百分点 |
Hebbia 技术团队成员 Kavita Anand 指出:“GPT-6 Astra 是我们见过的首个在‘内容精度’与‘指令遵循’两个维度上同时排名第一的模型。它生成的 PowerPoint 演示文稿不仅符合品牌规范,更具备人类水准的专业感。”
二、 安全防线:对抗性蒸馏的深度攻防
在模型能力提升的同时,OpenAI 也面临着“模型能力被窃取”的风险。对抗性蒸馏是指攻击者利用前沿模型的输出(尤其是推理链)来训练自己的模型,从而避开原有的安全护栏。
什么是对抗性蒸馏的风险?
如果恶意行为者通过蒸馏获取了模型的网络安全或生物研究能力,并将其部署在没有安全审查的环境中,原本模型拒绝回答的攻击性请求可能会被这些“学生模型”执行。
GPT-6.2 Astra 与 Sol 的防御升级
OpenAI 在最新的 GPT-6.2 Astra 和 GPT-6.2 Sol 中引入了分层防御机制,特别加强了对“私有推理(Protected Reasoning/Chain-of-Thought)”的保护。
- 防御训练:通过对抗性训练使模型识别并拒绝提取内部推理步骤的企图。
- 分类器保护:实时检测 API 输入输出,拦截泄露风险。
- 会话绑定:推理链现在与特定对话历史严格绑定,防止跨会话提取。
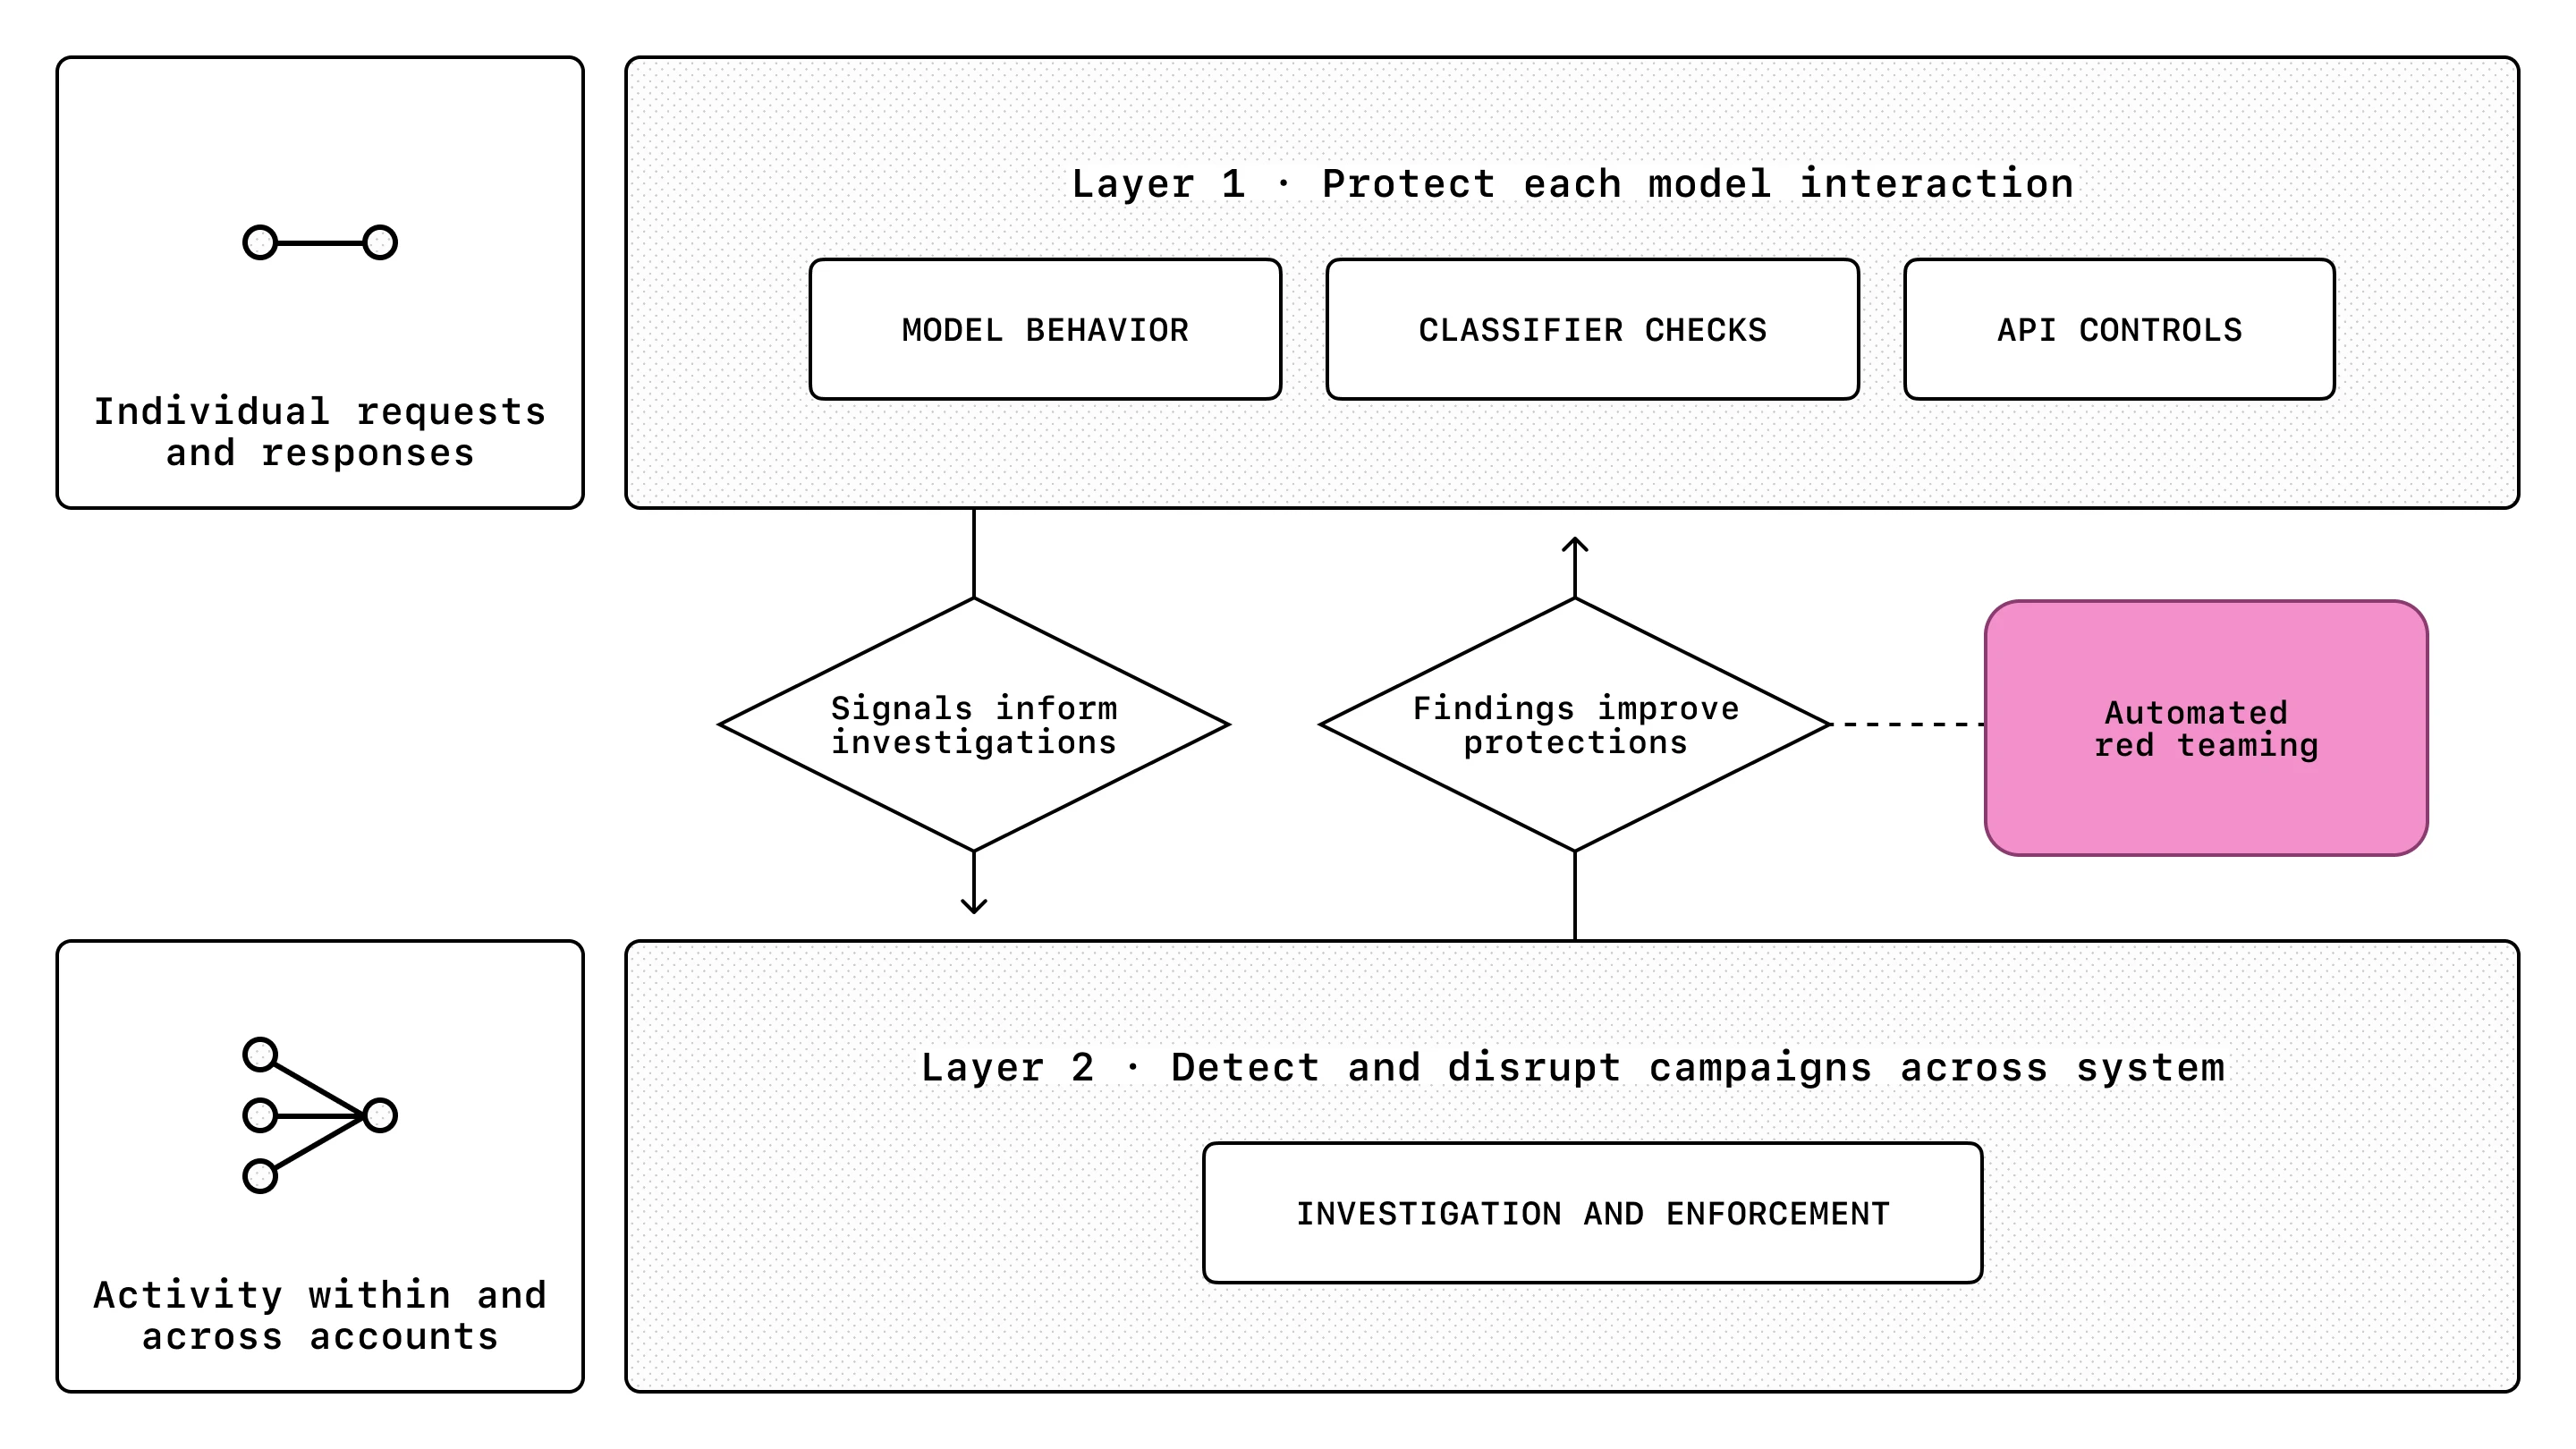
根据评估数据,攻击者从先前请求中提取保护推理的成功率(ASR)从 GPT-6 Astra 的 54.0% 断崖式下降至 GPT-6.2 Astra 的 0.2%。
三、 AI 时代的创造力与人类判断
尽管 AI 模型在处理金融数据和防御网络攻击方面展现了惊人效率,但人类的判断力依然不可或缺。正如传记作家 Walter Isaacson 在与 Google 的对话中所述,好奇心和团队协作是人类创新的核心。AI 的价值在于释放人类的时间,让我们从繁琐的数据整理(如金融底稿复核)中解脱,转向更高层级的战略思考。
四、 常见问题解答 (FAQ)
Q1: GPT-6 Astra 相比于 GPT-5 或其他模型主要改进在哪里? A1: 主要在于指令遵循能力和复杂推理的准确性。在 Hebbia 的测试中,它能够同时兼顾内容的打磨(Polish)与对复杂准则的遵守,而旧模型往往只能顾及其中之一。
Q2: 什么是“推理链”保护?为什么它很重要? A2: 推理链(Chain-of-Thought)是模型得出答案前的中间思考步骤。保护这些步骤不被 API 调用者非法提取,可以防止竞争对手通过蒸馏技术低成本复制 OpenAI 的核心推理能力,并降低安全风险。
Q3: 普通用户什么时候能用到这些安全提升? A3: OpenAI 已开始将选定的安全改进措施回传至 GPT-6 Astra,而 GPT-6.2 系列则已在 API 层面应用了最高标准的防御机制。
总结
从 Hebbia 的金融实践到 OpenAI 的底层安全机制,GPT-6 Astra 标志着 AI 正在进入一个更专业、更安全的新阶段。对于金融机构和开发者而言,这不仅意味着生产力的解放,也对数据安全和合规使用提出了更高的要求。